
DeepSeek Flash 1017:名字没变,模型更新了
官方如何解释同名更新?怎样核实版本?用鹈鹕骑车、弹球、局部改图和物品交换,看两条线路的真实输出与限制。
约 10 分钟 · 按此版本编写:2026-10-17 · deepseek-v4.1-flash
同样选择 deepseek-v4.1-flash,今天调用的模型,可能已经不是上个月的那一版权重。2026 年 10 月 17 日,DeepSeek 将 V4.1 Flash 更新为 V4.1-Flash-1017,官方网页、App 和 API 同步切换。调用名称保持兼容,版本却发生了更新。
这篇文章分开回答三件事:官方究竟更新了什么、怎样确认自己在用哪个版本,以及用鹈鹕骑车等小实验,能实际观察到什么。
deepseek-v4.1-flash,本次维持现有售价。DeepSeek 官方直连接口使用的名字是 deepseek-flash,两者属于不同服务的调用名称。官方发布页见10 月 17 日更新说明。资料核对与测试日期:2026 年 10 月 17 日。下文明确区分官方公布的数据与本站小样本实测。
同名更新的解释 · 怎样核实版本 · 直接看同题效果 · 缓存与并发实测
为什么名字没变,能力却变了?
接口里的 model 可以是一个持续更新的服务名称,权重版本则是某次具体发布。DeepSeek 的更新日志确认了这次升级;模型与价格页把 deepseek-flash 对应的版本列为 DeepSeek-V4.1-Flash-1017。
官方还说明,部分更早的名称,例如 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp,虽然仍然接受请求,原先对应的模型已经下线,实际由新版提供服务。因此,名称相同并不等于权重始终相同,旧名称仍能调用也不等于旧版本还在运行。这项说明针对 DeepSeek 官方 API;第三方服务的名称映射需另行核实。
| 看到的名称 | 它表示什么 | 能否据此确认快照 |
|---|---|---|
deepseek-flash | 官方持续提供服务的调用名 | 需结合当日官方版本表 |
deepseek-v4.1-flash | NezhaGate 的现有调用名 | 名称本身不能认证底层权重 |
DeepSeek-V4.1-Flash-1017 | 10 月 17 日发布的权重版本 | 自部署需进一步固定权重仓库与 commit |
1017 实际更新了什么?
官方将它描述为 V4.1 Flash 的一次小版本更新。发布说明提到,基于自反馈的强化学习训练提升了从零开发完整项目的能力,包括游戏与 3D 场景;同时改善任务运行时间和输出长度,并重点适配 DeepSeek Harness、CodeBuddy、WorkBuddy 等框架。使用 DeepSeek Harness 时,官方建议升级到 0.2.1-rc.1 或更高版本。
这不意味着每条普通对话都一定更快,也不意味着某个短提示词必定出现明显差异。项目开发效果还受工具、执行环境、思考预算和验收步骤影响。1M 上下文、视觉理解等能力应结合该型号原有说明理解,不能全部当作 1017 新增功能。
下面选取官方模型卡公布的新旧对照。数值是官方评测报告,本站没有复现这些完整基准;“提升”为两个分数相减的百分点。
| 官方基准 | 更新前 V4.1 Flash | 1017 | 提升 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 个百分点 |
| ProgramBench | 20.3 | 29.1 | +8.8 个百分点 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 个百分点 |
| HLE,无工具 | 36.8 | 42.6 | +5.8 个百分点 |
模型卡注明,Terminal-Bench 使用 Claude Code harness,DeepSWE 使用 Mini-SWE-V2。换工具环境、提示词或预算后,不能直接套用这些成绩。
怎样辨别自己是否用到了这次更新?
- 先核对服务的版本说明和日期。直连官方,查官方模型表;通过第三方,查该服务是否明确说明同名型号已切换,以及能否固定版本。
- 需要可重复实验时,记录具体版本来源。自部署可分别使用旧版仓库与1017 仓库,固定 commit、推理代码与模板。托管接口应保留服务方版本承诺、请求编号和测试时间。
- 同题测试验证效果。固定提示、思考模式、输出预算和工具条件,记录所有成功与失败。它可以帮助选用服务,但不能单独认证权重身份。
model 字段、答对一道题或画好一只鹈鹕,都不足以证明版本。网关可以规范化名称,模型也可能答错自己的身份。我们的同题实验怎样做?
我们按同一调用名测试原线路 A 与新线路 B,保留每次原始输出。A 是否仍停留在更新前权重,尚无固定快照证据。所以接下来的图和分数属于两条线路在该时间窗口的对照,不能冒充已经认证的新旧权重实验。上面的官方表格才是官方公布的新旧版本对比。
两组在同一测试机运行,逐题交替先后顺序,每次只提交一个请求。参数相同:temperature=1、top_p=1、思考开启、reasoning_effort=high、max_tokens=16384。不添加画图技巧,不要求模型根据渲染结果返工,失败样本也保留。服务端的隐藏模板与调度无法在本次测试中控制。
实验一:鹈鹕骑自行车
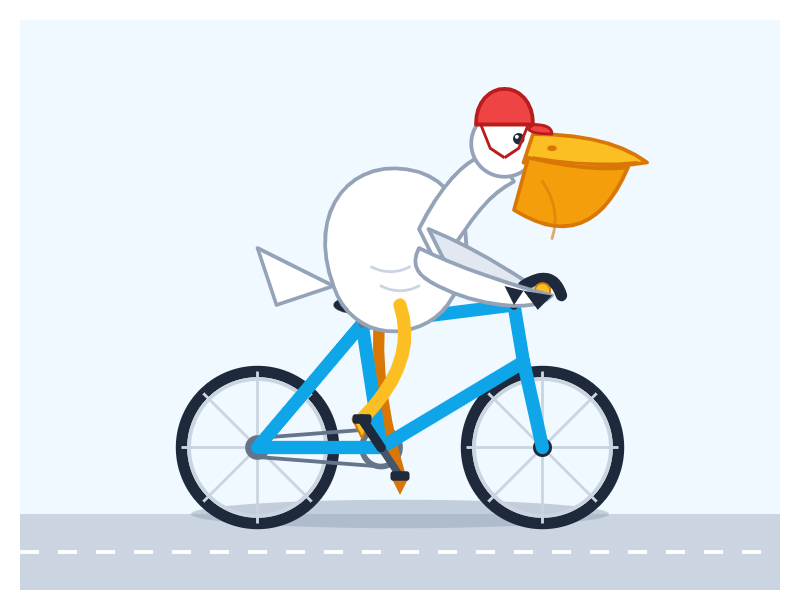
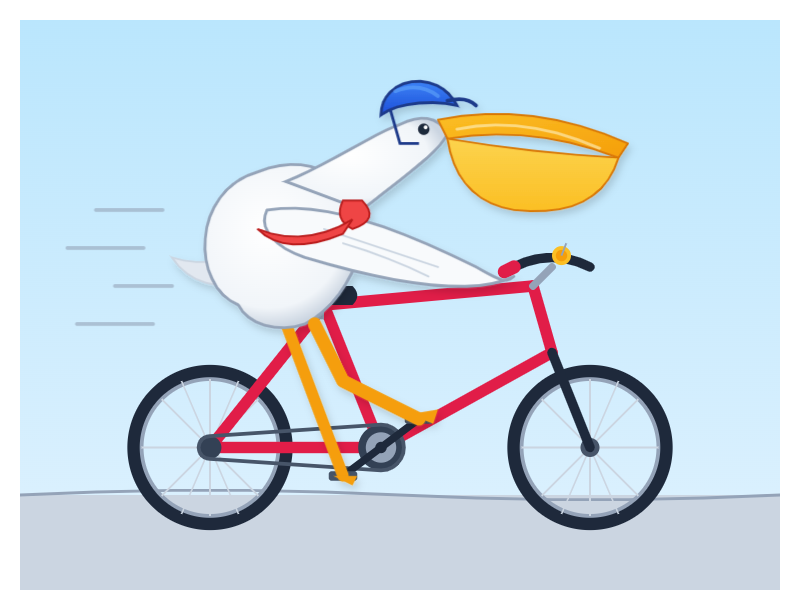
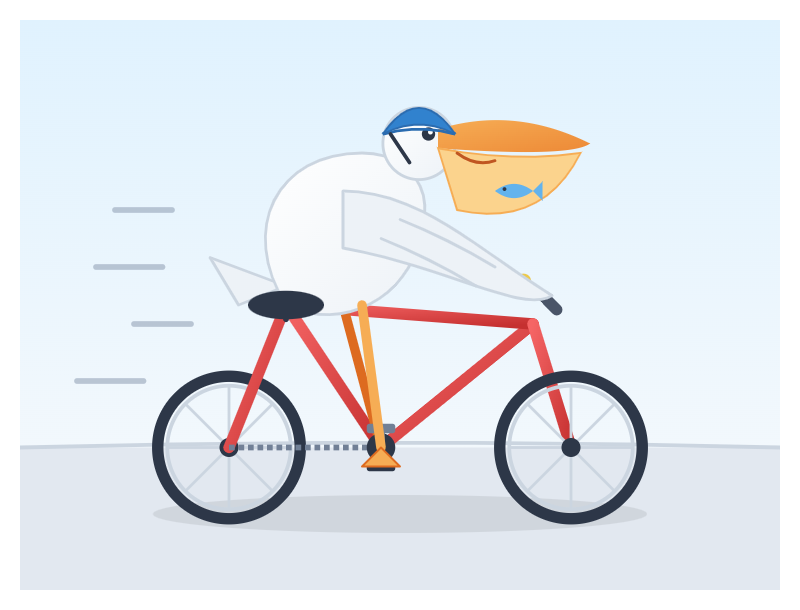
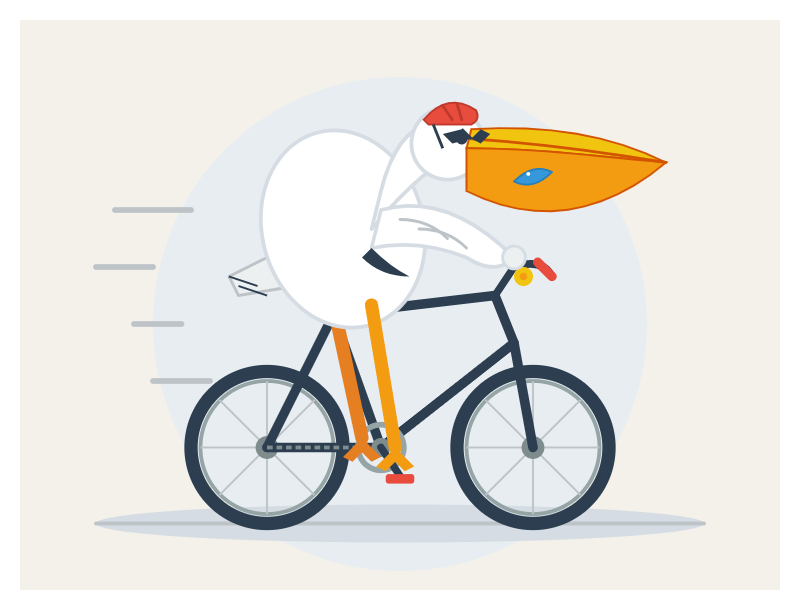
这道题来自 Simon Willison 在 2024 年 10 月 25 日的实验,原始代码库为 simonw/pelican-bicycle。它要求语言模型直接写 SVG 代码,再由浏览器把代码画出来。
Generate an SVG of a pelican riding a bicycle
看图时,可以依次检查:鸟是否能辨认成鹈鹕,车是否有合理的两轮和车架,鸟的身体、脚与车的接触关系是否自然。SVG 能打开只是第一步。每组生成三次,全部列出,避免只挑最好的一张。
提取的原始代码
完整原始回答
提取的原始代码
完整原始回答
提取的原始代码
完整原始回答
提取的原始代码
完整原始回答
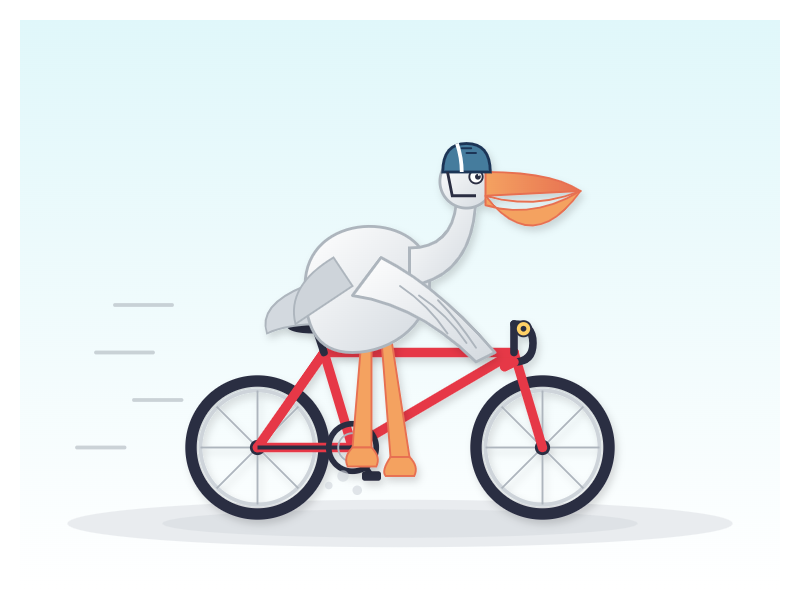
提取的原始代码
完整原始回答
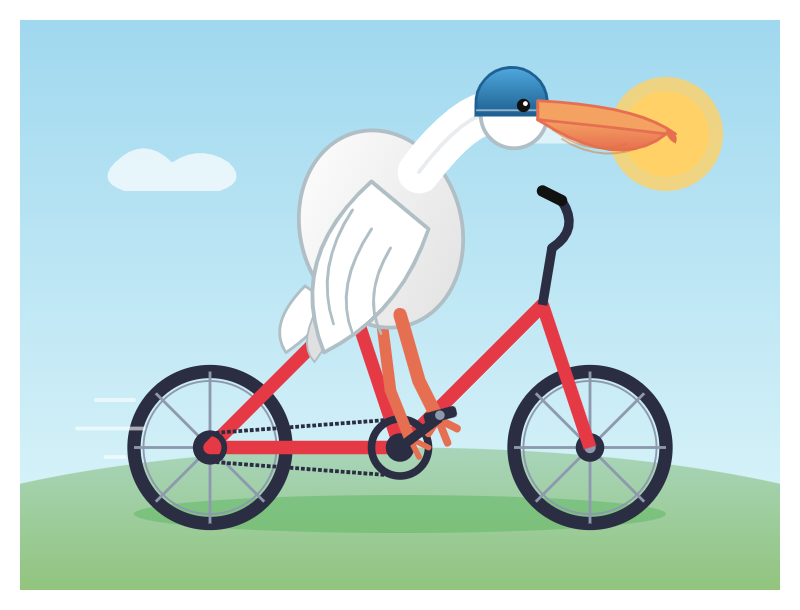
提取的原始代码
完整原始回答
作者后来也讨论了针对这道热门题训练的问题。一张图适合直观看空间表达,不能代替广泛能力评估。
实验二:旋转六边形里的弹球
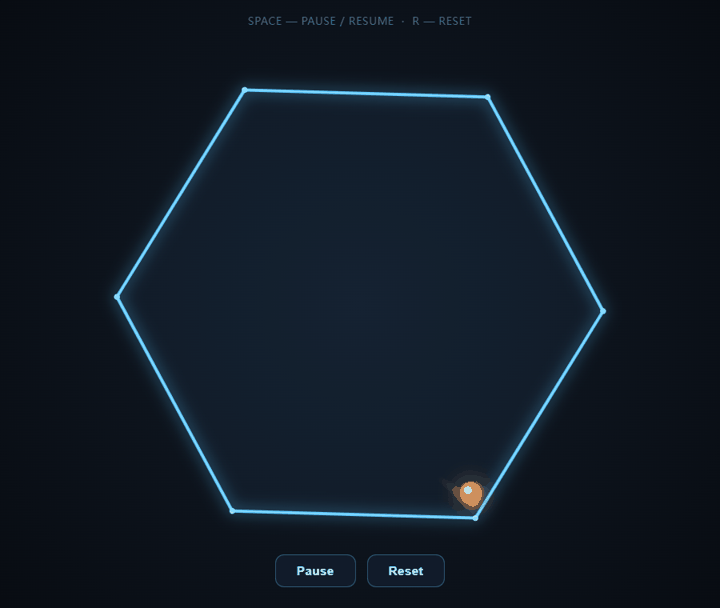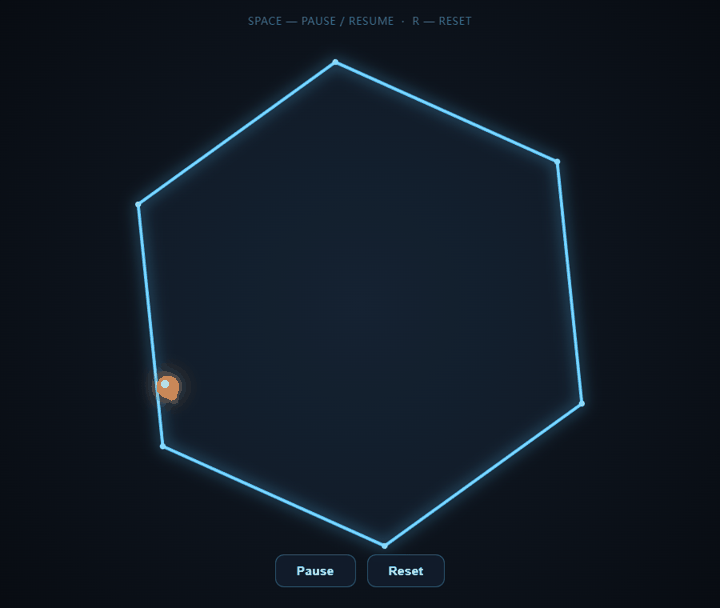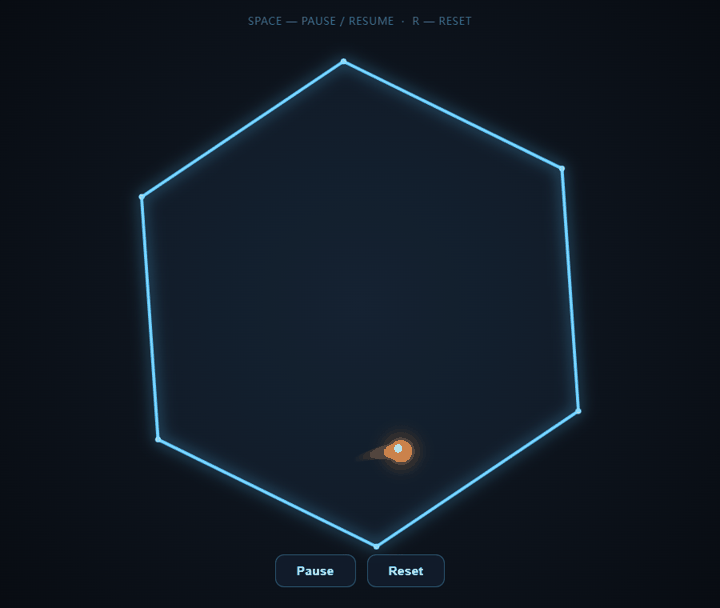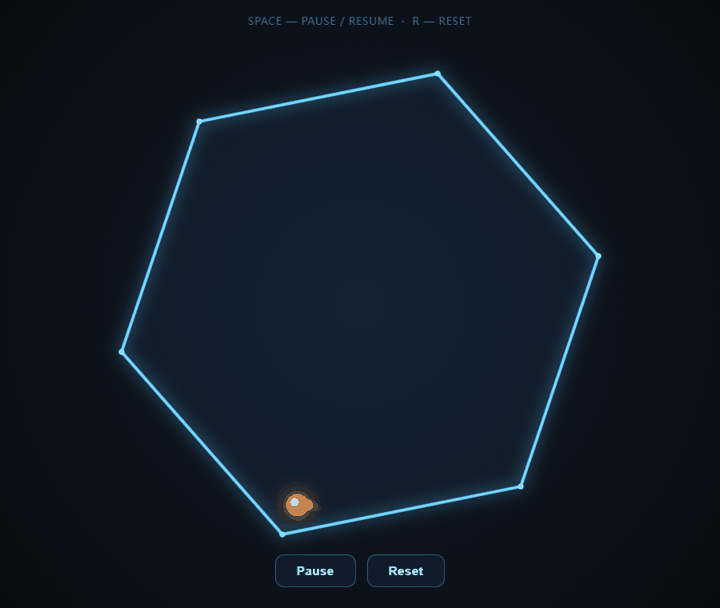
这个 GitHub 挑战要求模型实现一个受重力与摩擦影响、在旋转六边形内反弹的小球。为了便于查看,我们把原挑战的 Python 程序改成无外部依赖的单文件 HTML,并统一加入暂停与重置按钮;这属于本站改编题。
它比“页面能出现一个球”更难:六边形要旋转,球不能经常穿墙,运动要随时间推进,控件要实际有效。每组各两次,下面保留运行画面与独立检查结果;截图好看不等于物理模拟准确。
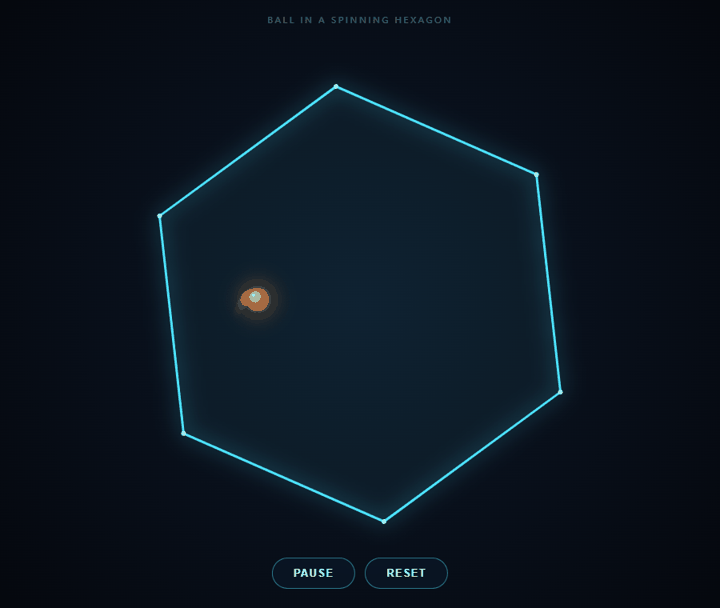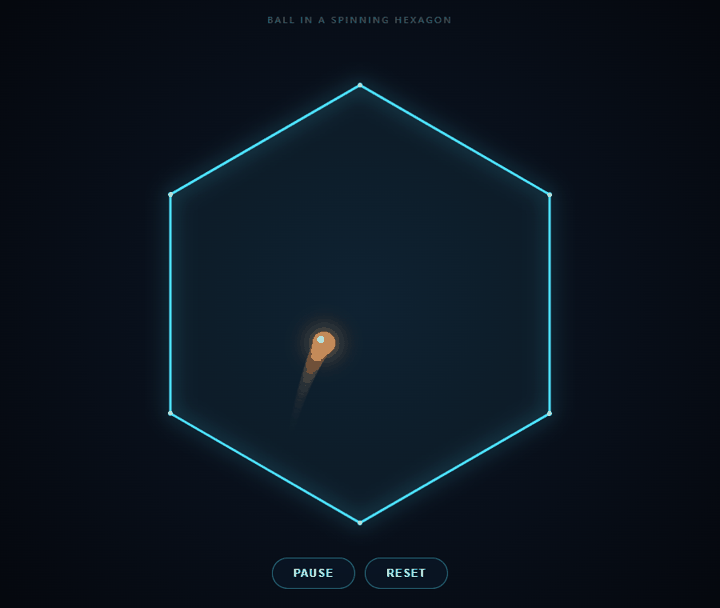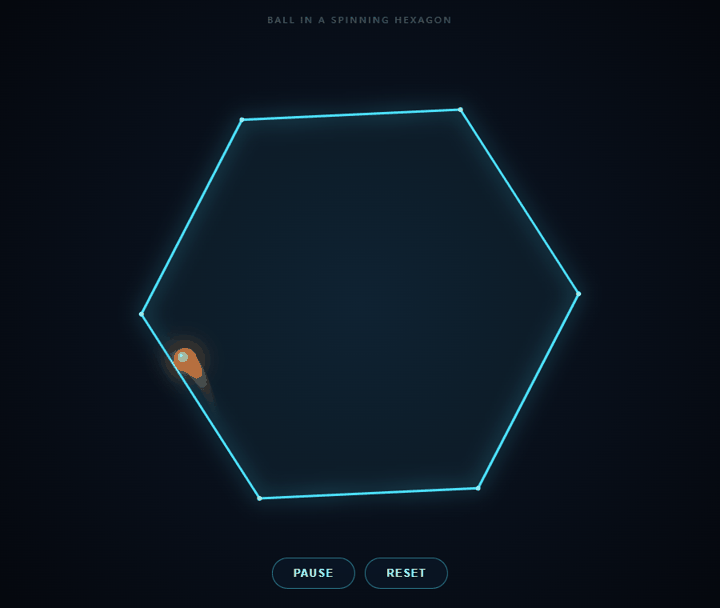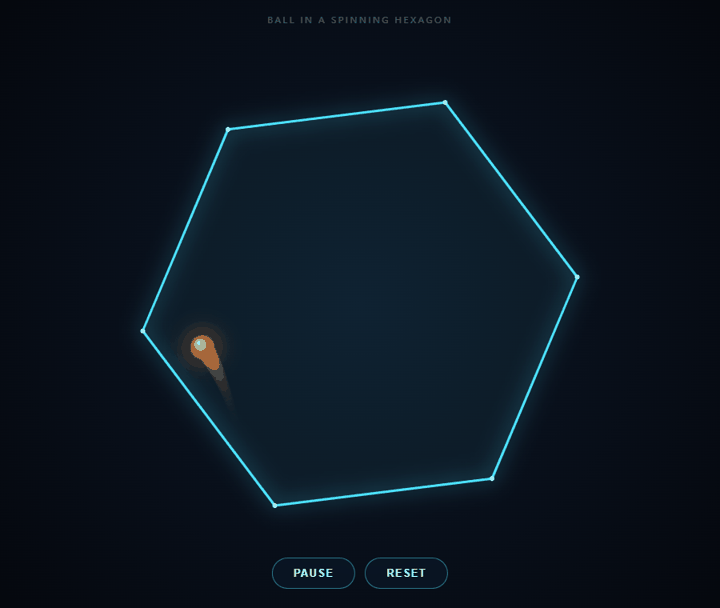
提取的原始代码
完整原始回答
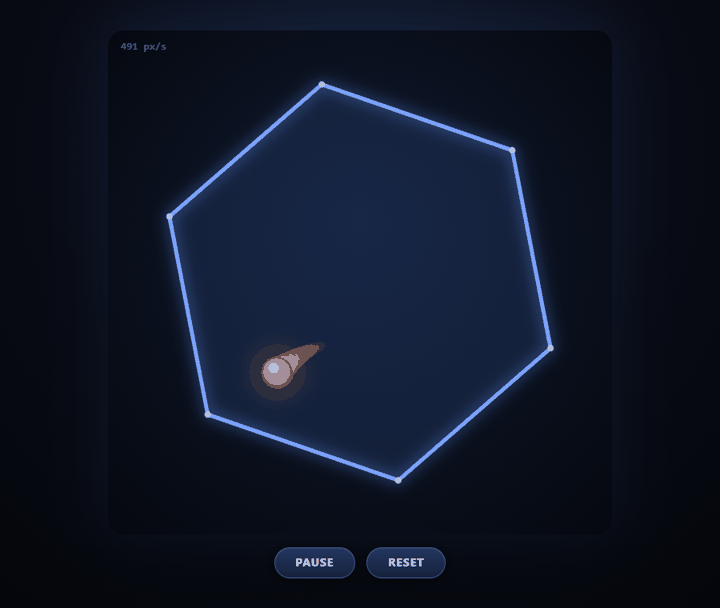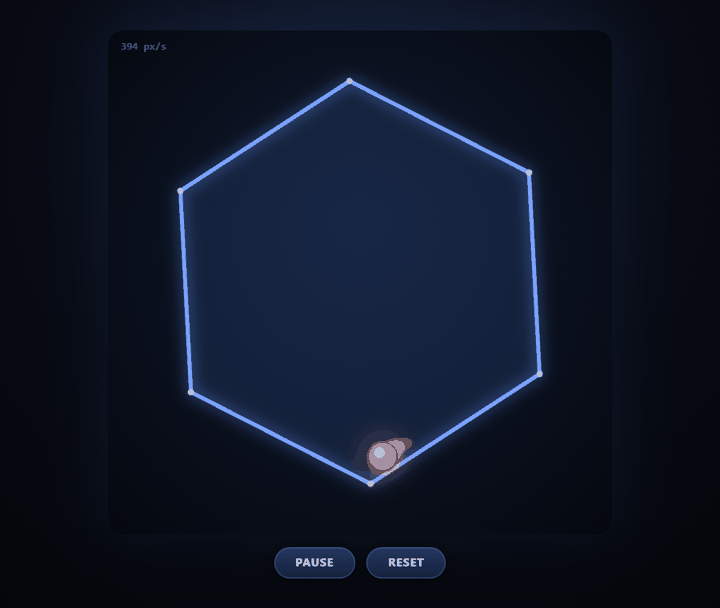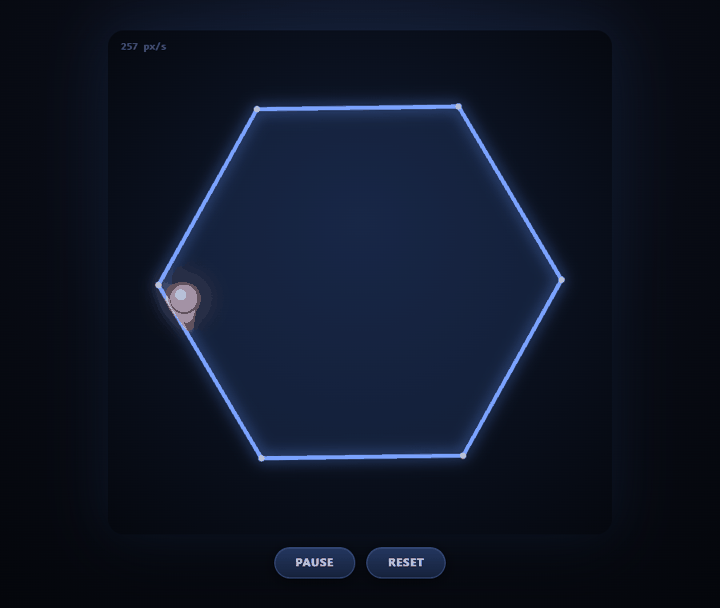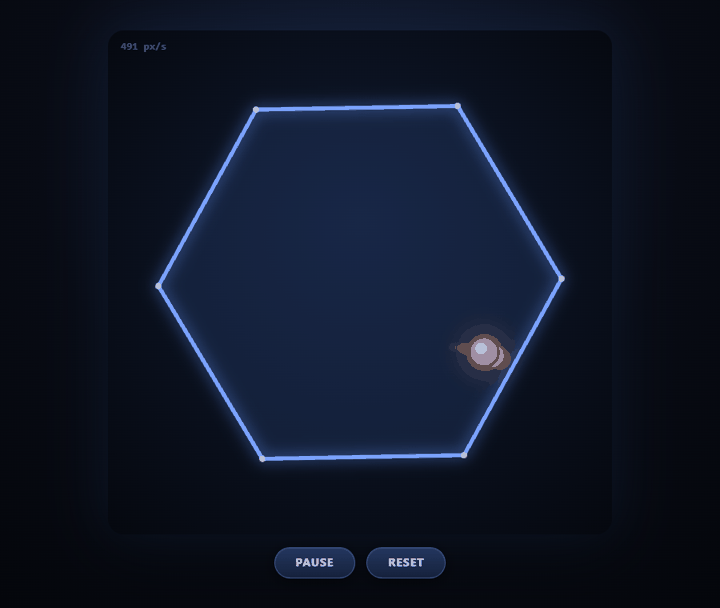
提取的原始代码
完整原始回答
提取的原始代码
完整原始回答
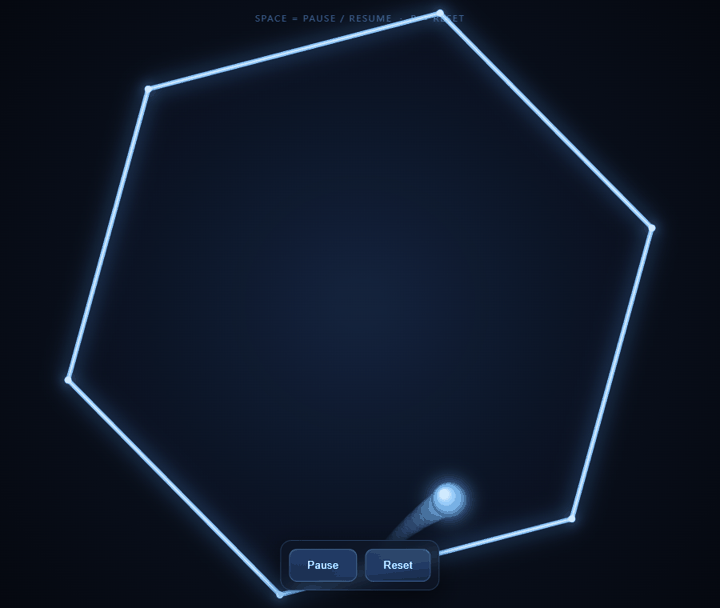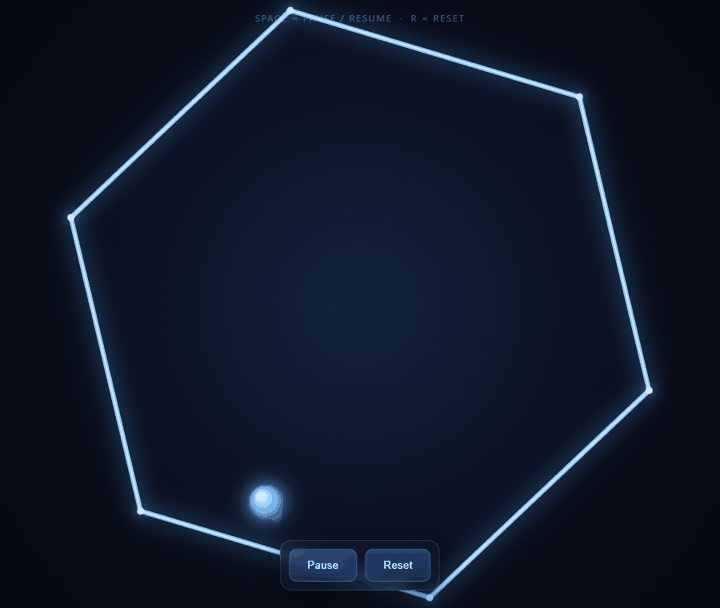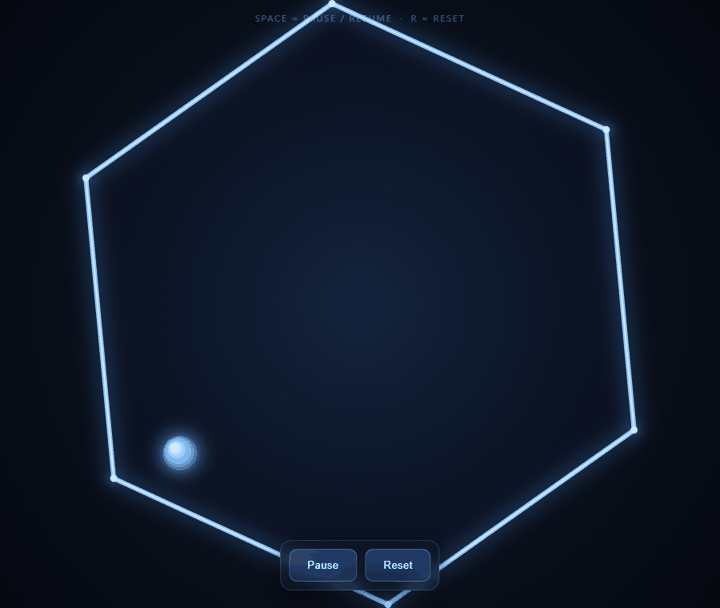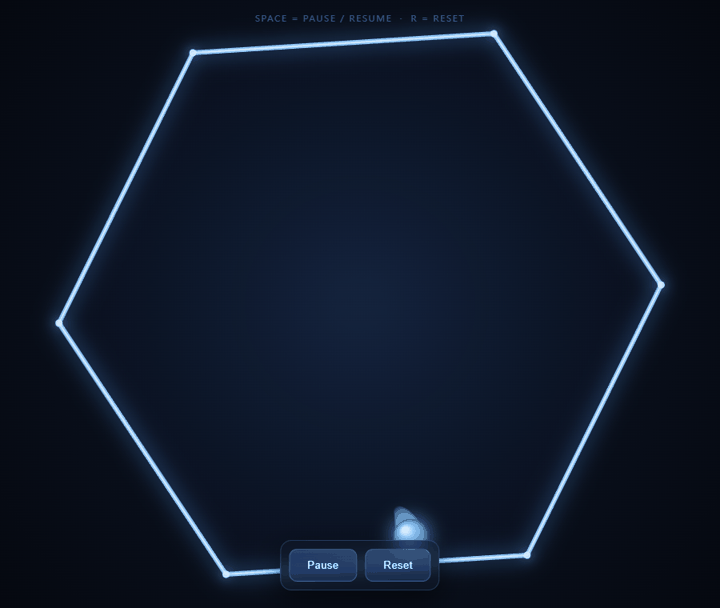
提取的原始代码
完整原始回答
| 样本 | 动画/暂停/恢复 | 纯HTML格式 | 短时边界观察 |
|---|---|---|---|
| A hexagon-1 | 通过 | 未通过 | 越界超过2px的样本 0/1271 |
| A hexagon-2 | 通过 | 未通过 | 越界超过2px的样本 0/1271 |
| B hexagon-1 | 通过 | 未通过 | 越界超过2px的样本 0/1211 |
| B hexagon-2 | 通过 | 未通过 | 越界超过2px的样本 0/1356 |
有些回答夹带说明文字;展示时只提取其中完整的HTML代码,没有修正程序,格式问题单独记为未通过。边界观察来自短时运行中的绘图坐标,不能证明长期稳定或所有碰撞的物理准确性。
实验三:只改指定部位,其他地方别动
这个实验借鉴 SVGEditBench 的局部编辑思路,使用本站自制图形:一个红色圆、一个蓝色方块和一行文字。两道独立题分别要求只把圆改绿,以及只把方块左移 20 个单位。
除看图之外,程序还逐项检查 XML:目标属性是否正确,其他元素、属性和文字是否保留。这样可以识别“重新画了一张很像的图,但顺手改了别处”的情况。本次不是 SVGEditBench 完整数据集成绩。
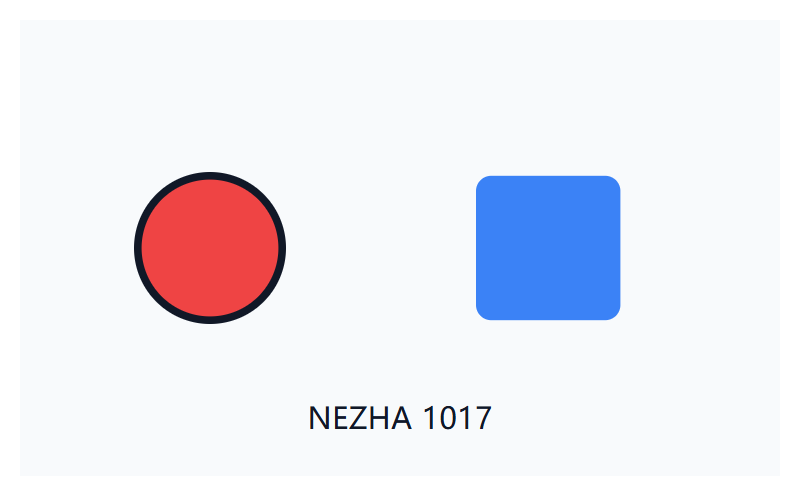
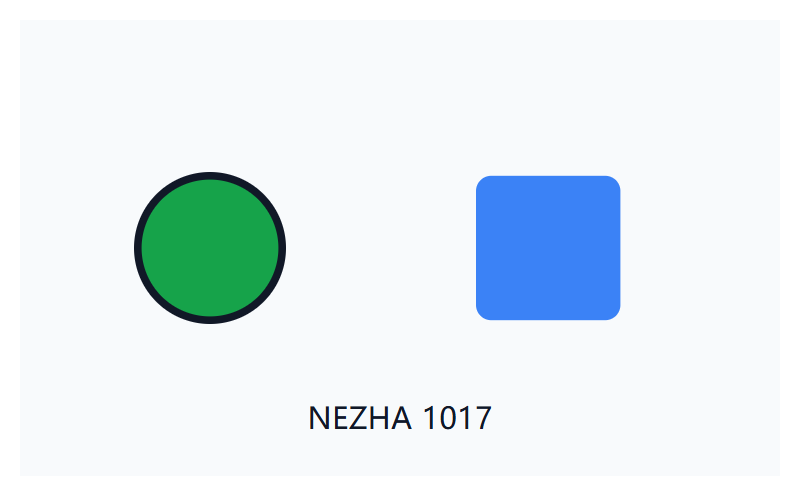
提取的原始代码
完整原始回答
提取的原始代码
完整原始回答
提取的原始代码
完整原始回答
提取的原始代码
完整原始回答
A: 2/2 精确修改与保留检查通过。 B: 2/2 精确修改与保留检查通过。
实验四:物品交换十二局
最后借鉴 BIG-bench 的物品追踪任务:七个人起初各拿一件物品,依次交换 24 次,最后请模型给出所有人的物品。我们用固定随机种子生成十二局新题,并用程序模拟交换得到标准答案。
一局必须七个人全部答对才算通过,同时检查返回内容能否直接按 JSON 解析。这个小实验观察连续状态更新与格式遵循,不能当成 BIG-bench 官方成绩。
| 线路 | 整局全对 | JSON | 完成/终止 |
|---|---|---|---|
| A | 未取得可解析答案 | 未通过 | 51.65s |
| B | 未取得可解析答案 | 未通过 | 232.46s |
实际使用还要看缓存、首字与长上下文
画图之外,我们还完成了接口验收。以下是本次新线路在指定合成工作负载上的观测,不是长期容量承诺,也不是上面趣味题的耗时:
| 项目 | 本次观测 | 怎样理解 |
|---|---|---|
| 8 个同时请求 | 16/16 完整交付;首字 P50/P95 为 9.75/12.11 秒 | 首字指最终回答的第一个非空内容,思考内容另外计时 |
| 32 个同时请求 | 64/64 完整交付,严格格式正确 63/64;首字 P50/P95 为 28.01/39.76 秒 | 更高并发出现更多排队,不能据此承诺长期 32 并发 |
| 重复前缀缓存 | 15,134 个输入 token 中命中 14,976 个,约 98.96% | 已核实计费折扣;也观察到命中后首字约 47 秒的个例 |
| 长上下文 | 1,034,762 个输入 token;五处随机标记全部找回 | 证明该次多点抽取成功,不等于验证了任意长文推理或 384K 输出 |
缓存适合把稳定资料放在前面,把每次变化的问题放在后面。实际命中与否以返回用量为准;缓存是尽力复用,不能保证每次立即命中或一定降低延迟。具体机制可参阅官方缓存说明。
这些结果能帮助你做什么决定?
官方资料能够确认1017是一次模型权重更新,而同名API可以随服务升级。我们的三轮鹈鹕中,两条线路都生成了可辨认的鹈鹕和自行车;原线路完成耗时24.07–40.53秒,新线路70.34–91.75秒,这组样本并不支持“新线路一定更快”。
两组均通过2/2局部编辑检查和2/2弹球运行检查;四份弹球回答都没有遵守只返回HTML的格式要求。十二局交换题,两组都在16K预算内未给出最终答案。由于对照线路的旧版快照没有认证,两组也可能已经使用相同版本。这篇文章不把线路差异归因为1017升级,也不宣布某一组全面胜出。
接入时继续使用现有的 deepseek-v4.1-flash。需要长资料处理,可以先用自己的典型文档做小规模验证;需要完整项目开发,除模型之外,还要给它可用的文件、执行环境和明确验收条件。
这次官方同时开放了 Search/Fetch API,它们是独立接口。不能因为型号更新,就默认第三方 Chat 接口自动具备联网搜索能力。官方能力、服务实际接入能力与某次实验结果,应分别核实。
其它教程:SillyTavern · Cherry Studio · Cline · Webhook · USDT
